Baixe Wavify – Ferramenta Avançada de Integração de Voz com IA
Visão geral
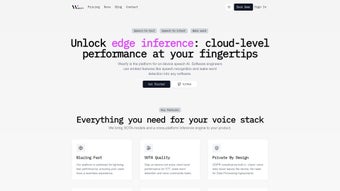
Wavify é uma plataforma de integração de voz com IA de última geração, criada para desenvolvedores que desejam incorporar interação em linguagem natural em suas aplicações sem comprometer a privacidade ou o desempenho. Alimentada por uma arquitetura local, Wavify processa os dados de fala no próprio dispositivo, garantindo que as gravações dos usuários nunca deixem o aparelho, ao mesmo tempo que oferece precisão de nível de nuvem para Reconhecimento de Fala (STT), detecção de palavra‑de‑ativação e tratamento de comandos. Essa combinação de segurança, velocidade e escalabilidade faz do Wavify a escolha ideal para ambientes de alta responsividade, como monitoramento de saúde, infotainment automotivo e ferramentas de e‑learning.
O que realmente diferencia o Wavify dos SDKs de voz genéricos é seu motor multilíngue e a amplitude de plataformas suportadas. Seja você alvo de um servidor Linux, um desktop Windows, um cliente macOS, um app móvel iOS, um dispositivo Android ou até mesmo uma placa embarcada com recursos limitados, o Wavify oferece uma API consistente e documentação que reduz o esforço de integração a poucas linhas de código. O design modular da plataforma permite habilitar apenas os recursos que você precisa — seja detecção simples de palavras‑chave ou IA conversacional completa — para que você mantenha o tamanho do binário pequeno e o consumo de energia baixo.
Além das capacidades de voz essenciais, o Wavify oferece utilitários avançados como treinamento de modelo personalizado, troca de idioma em tempo real e fallback transparente para serviços de nuvem quando um dispositivo não consegue atender a um requisito específico de latência. O SDK inclui registro robusto, diagnóstico e mecanismos de atualização over‑the‑air, garantindo que seu aplicativo habilitado para voz permaneça atualizado com as últimas melhorias em modelagem acústica e compreensão de linguagem natural.
Principais recursos e capacidades
- Reconhecimento de fala no dispositivo: STT de baixa latência com processamento focado na privacidade.
- Detecção de palavra‑de‑ativação: Palavras‑chave personalizáveis que ativam seu app sem tocar na tela.
- Tratamento de comandos de voz: Análise de intenções integrada para execução rápida de comandos.
- Suporte multilíngue: Mais de 30 idiomas e dialetos, com detecção automática de idioma.
- Compatibilidade multiplataforma: SDKs nativos para Linux, Windows, macOS, iOS, Android e Linux embarcado.
- Treinamento de modelo personalizado: Envie conjuntos de dados específicos de domínio para ajustar modelos acústicos e de linguagem.
- Fallback híbrido para nuvem: Troca transparente para processamento em nuvem quando os recursos locais são insuficientes.
- Atualizações em tempo real: Atualizações OTA de modelo e firmware sem interromper a experiência do usuário.
- API amigável ao desenvolvedor: Modelo de requisição/resposta baseado em JSON com extensos exemplos de código.
- Controles de segurança e privacidade: Criptografia de ponta a ponta, execução em sandbox e tratamento de dados em conformidade com GDPR.
Cada recurso é exposto por meio de um conjunto bem documentado de funções que podem ser chamadas a partir de linguagens populares como C++, Java, Swift, Kotlin e Python. O SDK também inclui um console de depuração visual, permitindo que desenvolvedores visualizem transcrições em tempo real, pontuações de confiança e formas de onda acústicas diretamente no dispositivo. Esse nível de insight acelera a resolução de problemas e ajuda a ajustar a experiência de voz para seu público‑alvo.
Como o Wavify é construído sobre arquiteturas de redes neurais padrão da indústria, os modelos são leves e altamente precisos. A plataforma utiliza técnicas de quantização e poda para manter a pegada de memória abaixo de 30 MB na maioria dos dispositivos móveis, ao mesmo tempo que atinge taxas de erro de palavra (WER) comparáveis aos principais serviços de nuvem. Para aplicações que exigem a máxima precisão — como ditado médico ou comandos de voz veiculares — o Wavify oferece um nível premium de modelo com WER inferior a 5 % em ambientes ruidosos.
Instalação, uso e compatibilidade
Começando
Instalar o Wavify é simples. Para Windows e macOS, baixe o instalador no site oficial; o pacote inclui binários pré‑compilados, cabeçalhos do SDK e projetos de exemplo. Usuários Linux podem obter um pacote .deb ou .rpm via linha de comando, enquanto desenvolvedores móveis obtêm o AAR Android ou o CocoaPod iOS diretamente do Maven Central ou CocoaPods, respectivamente. Sistemas embarcados são suportados por meio de uma biblioteca estática cross‑compiled que pode ser vinculada ao seu sistema de build de firmware (por exemplo, Yocto, Buildroot).
Após instalar o SDK, adicione os caminhos de inclusão apropriados e vincule contra a biblioteca libwavify. Um exemplo mínimo “Hello Voice” demonstra como inicializar o motor, carregar um modelo de palavra‑de‑ativação e iniciar um loop de escuta contínua. O código de exemplo está disponível em C++ para plataformas desktop e em Swift/Kotlin para mobile, garantindo que você possa prototipar rapidamente em qualquer dispositivo alvo.
Fluxo típico de integração
- Inicializar o motor: Chame
Wavify::initialize()com sua chave de API e a configuração desejada (idioma, nível de modelo, modo de privacidade). - Carregar recursos: Carregue modelos de palavra‑de‑ativação e de idioma usando
loadModel(). Você também pode fornecer um arquivo de gramática personalizado para reconhecimento de comandos. - Iniciar captura de áudio: Conecte o SDK à entrada do microfone. O Wavify suporta fluxos PCM, WAV e áudio bruto.
- Processar eventos: Registre callbacks para
onWakeWordDetected,onTranscriptionResulteonError. Os callbacks são executados em uma thread em segundo plano, portanto as atualizações de UI devem ser encaminhadas para a thread principal. - Manipular resultados: Use o payload JSON retornado para extrair intenção, confiança e quaisquer entidades extraídas (por exemplo, datas, números).
- Encerrar graciosamente: Libere recursos com
Wavify::shutdown()quando o app for fechado.
Suporte a sistemas operacionais
O Wavify roda nativamente nas seguintes plataformas:
- Windows 10/11 (x86 64)
- macOS 12 Monterey e posteriores (Apple Silicon & Intel)
- Ubuntu 20.04+, Debian, Fedora e outras principais distribuições Linux
- iOS 14+ (iPhone, iPad)
- Android 8.0 Oreo e posteriores
- Linux embarcado (ARM Cortex‑A, AArch64) com glibc ou musl
O SDK abstrai APIs de áudio específicas de cada plataforma, fornecendo uma interface unificada para captura de microfone e reprodução de áudio. Isso garante que desenvolvedores possam escrever um único código‑base que se comporte de forma consistente em todos os dispositivos suportados, reduzindo a sobrecarga de manutenção e acelerando os ciclos de lançamento.
Prós, contras e perguntas frequentes
Prós
- Processamento no dispositivo protege a privacidade do usuário e reduz a latência.
- Suporte multilíngue extensivo permite implantações globais.
- SDKs multiplataforma simplificam a integração em desktop, mobile e embarcado.
- Treinamento de modelo personalizado adapta o motor a vocabulários específicos de domínio.
- Fallback híbrido para nuvem garante confiabilidade em cenários de recursos limitados.
Contras
- Curva de aprendizado inicial para desenvolvedores não familiarizados com pipelines de áudio.
- Recursos avançados (por exemplo, treinamento de modelo personalizado) exigem assinatura paga.
- Implantações embarcadas podem precisar de cuidadoso orçamento de memória em hardware mais antigo.
- Documentação, embora abrangente, poderia se beneficiar de mais tutoriais em vídeo.
- A precisão da transcrição em tempo real pode degradar em ambientes extremamente ruidosos sem pré‑processamento adicional de cancelamento de ruído.
Perguntas frequentes
O Wavify é gratuito para projetos pessoais?
Sim, o Wavify oferece um plano gratuito que inclui reconhecimento básico de fala, detecção de palavra‑de‑ativação e suporte para até três idiomas. O plano gratuito é ideal para hobbyistas, protótipos e aplicações de pequena escala. Para uso comercial ou recursos avançados como treinamento de modelo personalizado, será necessário atualizar para um plano pago.
Como o Wavify garante a privacidade dos dados?
Todo o processamento de áudio ocorre localmente no dispositivo, ou seja, nenhum dado de voz bruto é transmitido a servidores externos. Apenas métricas de uso anonimizadas são enviadas opcionalmente para análise, e isso pode ser desativado no arquivo de configuração. O Wavify está em conformidade com GDPR, CCPA e outras regulamentações regionais de privacidade.
Posso usar o Wavify em um Raspberry Pi?
Absolutamente. O Wavify fornece uma biblioteca pré‑compilada ARM32/ARM64 para o Raspberry Pi OS. O SDK roda de forma eficiente no Pi 4, entregando latência inferior a 200 ms para detecção de palavra‑de‑ativação e menos de 500 ms para reconhecimento completo de fala em um modelo padrão de 2 GB.
Quais idiomas são suportados por padrão?
O Wavify suporta Inglês, Espanhol, Mandarim, Francês, Alemão, Japonês, Coreano, Português, Italiano, Holandês, Russo, Árabe, Hindi e diversos dialetos regionais. Idiomas adicionais podem ser adicionados através do pipeline de modelo personalizado, que permite o upload de pacotes de idioma fornecidos pela comunidade de parceiros do Wavify.
Como recebo atualizações do SDK?
O Wavify inclui um módulo de atualização OTA (over‑the‑air) que verifica novos lançamentos de modelo ou motor na inicialização. Você também pode baixar manualmente a versão mais recente no site ou via gerenciadores de pacotes como npm (para wrappers JavaScript) e pip (para bindings Python).
Conclusão – Você deve baixar o Wavify?
Se você é desenvolvedor e procura um motor de voz confiável, focado em privacidade, que funcione em desktop, mobile e plataformas embarcadas, o Wavify é uma escolha atraente. Seu processamento no dispositivo oferece interações rápidas e responsivas, enquanto o amplo suporte multilíngue abre portas para mercados globais. O design modular do SDK permite começar com detecção simples de palavra‑de‑ativação e, gradualmente, adicionar STT sofisticado ou modelos de linguagem personalizados à medida que seu produto evolui.
O plano gratuito fornece funcionalidade suficiente para experimentação e pequenos projetos, e os planos pagos desbloqueiam recursos de nível empresarial, como treinamento de modelo personalizado, suporte prioritário e modelos de maior precisão. Embora a curva de aprendizado possa ser um pouco íngreme para quem está iniciando na engenharia de áudio, a documentação completa, os códigos de exemplo e os fóruns ativos da comunidade ajudam a suavizar o processo de integração.
Em resumo, o Wavify equilibra desempenho, segurança e flexibilidade de uma forma que poucos concorrentes conseguem igualar. Seja você quem esteja construindo um eletrodoméstico inteligente controlado por voz, uma ferramenta de ditado médico mãos‑livres ou um aplicativo educacional de aprendizado de idiomas, o Wavify fornece os blocos de construção para criar uma experiência polida e interativa. Baixe o Wavify hoje e comece a transformar palavras faladas em ações poderosas dentro do seu software.
Clique aqui para baixar a versão mais recente e explore o sandbox gratuito para desenvolvedores. Para preços, opções de suporte e especificações técnicas detalhadas, visite o site oficial do Wavify.
O Wavify impressiona com seu processamento no dispositivo, cobertura extensa de idiomas e suporte cruzado de plataformas. Embora a documentação pudesse ter mais guias visuais e a pegada embarcada possa ser um desafio para hardware muito limitado, o valor geral para desenvolvedores que desejam adicionar interatividade por voz é alto. O plano gratuito é generoso, e os recursos premium justificam o preço para implantações comerciais.